AI検索の普及により、SEOの概念は「検索エンジン最適化」から「AI最適化(AIO)」へと進化しています。
LLMO(Large Language Model Optimization)とは、ChatGPTやGemini、PerplexityといったLLMがWeb情報をどのように理解・引用するかを最適化する新たな考え方です。
ここでは、AI時代に欠かせないサイト設計10の必須ポイントをチェックリスト形式で解説します。
初心者向けのチェックリストではなく、専門的な内容が多数含まれております。Web制作会社やマーケティング会社向けに近い内容となる旨、ご了承ください。
クーミルでは、LLMOコンサルティングのみならず、実行支援まで一貫して対応可能です。Web制作会社だからこそAIフレンドリーなサイト構造へ改修することも可能です。
お悩みを無料で相談する
Step1
ありがとうございます
弊社にご相談頂きまして
誠にありがとうございます。
クーミル株式会社では、
1つ1つのご相談を真剣に考え、
最適解をご提供出来るよう日々努めております。
可能な限り、即日ご返信を心掛けておりますが、
相談内容や、
営業日の関係で少々、
お待たせさせてしまうかも知れません…。
目次
- そもそもLLMO対策とは?SEOとの違い
- LLMO(Large Language Model Optimization)の定義
- SEOとAIO(AI Optimization)の関係
- AIがサイトを評価する仕組み(RAG・ナレッジグラフ・構造化データ)
- チェックリスト①コンテンツの意味構造を明確化する
- 見出し(H2/H3)で質問意図に対応させる
- FAQ構造や定義ページでクエリファンアウトに備える
- ナレッジグラフを意識した内部リンク設計
- チェックリスト②構造化データを整備する
- Article・FAQ・Organizationスキーマの設定
- 著者・会社・記事の関係をスキーマで明示
- AI検索に引用されやすいJSON-LD設計例
- チェックリスト③E-E-A-T(専門性・信頼性)を強化
- 監修・実績・著者情報を明記する
- 権威性のある外部参照リンクを活用
- AIが信頼する「出典情報」の作り方
- チェックリスト④トピッククラスタ構造を構築
- ピラーページとサテライト記事の設計
- トピックごとの内部リンク戦略
- AIが理解する「知識のまとまり」を作る方法
- チェックリスト⑤定期的な情報更新
- dateModifiedタグで更新を明示
- LLM再学習の周期を意識した更新頻度
- 古い情報を削除・統合する運用ルール
- チェックリスト⑥AIが読みやすい文章構造を採用する
- 短文+箇条書きで論理を分割
- 見出し下に要約文(150字前後)を配置
- 生成AIが部分引用しやすい書き方とは
- チェックリスト⑦ページエクスペリエンス(UX)を最適化
- Core Web Vitalsの改善でAI評価を高める
- モバイルにおける読み込み速度の最適化
- AI検索でサムネイル・構造が崩れない設計
- チェックリスト⑧外部評価・被リンクの質を見直す
- AIは「被リンク元の信頼性」を解析している
- ナレッジネットワークに参加する発信戦略
- SNS・プレス・引用対策でAI理解を促進
- チェックリスト⑨AI引用率をモニタリングする
- 主要LLM(Perplexity・Bing Copilot・SGE)での引用傾向を分析
- AI経由トラフィックの測定方法
- チェックリスト⑩AI検索時代のブランド設計を行う
- LLMに認識されるブランドストーリーの構築
- 企業情報・理念・ミッションを構造化データ化
- AI検索で「ブランドワード回答」を得る方法
- まとめ
そもそもLLMO対策とは?SEOとの違い
AIがユーザーの質問に直接回答する時代、単に「上位表示される」だけではなく「AIに引用される」ことが重要になっています。
LLMO対策は、AIがサイトを理解・信頼し、自然な形で引用するための設計思想です。
LLMO(Large Language Model Optimization)の定義
LLMOとは、「大規模言語モデル(LLM)」に最適化するための情報設計戦略です。
SEOがGoogle検索エンジン向けの最適化であるのに対し、LLMOはAIが言語的に情報を理解する構造を整えることに重点を置きます。
- AIが認識できる「サイト構造」にする
- FAQや定義型見出しで質問形式をカバー
- 構造化データによる機械理解の補強
- サイトの信頼性を向上させて、言及率を高める
- Web上にブランド情報量を増やし、LLMに学習させる
このような対策をLLMO対策としては実行します。
SEOとAIO(AI Optimization)の関係
AIOはSEOの進化形であり、検索エンジンではなくAIの出力結果に影響を与える最適化を指します。「SEO=表示順位の最適化、AIO=AI回答内での引用率最適化」と捉えると理解しやすいです。
| 対象 | SEO | LLMO(AIO) |
|---|---|---|
| 最適化対象 | 検索結果ページ | AI回答文面・引用リンク |
| 評価指標 | CTR・順位 | 引用率・AIトラフィック |
| 技術要素 | キーワード・内部リンク | 構造化データ・意味設計 |
AIがサイトを評価する仕組み(RAG・ナレッジグラフ・構造化データ)
LLMは、RAG(検索拡張生成)によって外部情報を収集し、ナレッジグラフで意味的関係を整理しています。
構造化データは、この「AIの理解辞書」に登録されるための最重要要素。AIがサイトを評価する際、信頼性・明確性・関係性を確認し、引用候補を決定しています。
チェックリスト①
コンテンツの意味構造を明確化する
AIに理解されるためには、「ページ内の情報構造」が極めて重要です。AIは質問と回答の対応関係や、見出しの文脈構造をもとに内容を解析しています。
見出し(H2/H3)で質問意図に対応させる
AIは検索意図を細分化して理解するため、「質問型の見出し構成」が最も効果的です。
人間の読者だけでなく、AIにとっても「H2=質問」「本文=回答」という構造は、意味の区切りとして明確に解析されます。
具体的な簡易イメージ
- H2:「LLMOとは何か?」
└LLMOとは、「大規模言語モデル(LLM)」に最適化するための情報設計戦略です。 - H3:「なぜAI時代に重要なのか?」
└LLMを活用した検索ニーズが増えているためです。
| 見出しタイプ | AIが認識しやすい構造例 | 効果 |
|---|---|---|
| 定義型 | 「LLMOとは何か?」 | 概念認識が高まる |
| 方法型 | 「LLMO対策の進め方」 | 手順抽出が容易 |
| 比較型 | 「SEOとLLMOの違い」 | クエリファンアウトに対応 |
| 注意型 | 「LLMO対策でやってはいけないこと」 | リスク情報をAIが補足理解 |
このような構造は、クエリファンアウトされたサブ質問に正確に対応し、AI検索時の引用率を高めます。
FAQ構造や定義ページでクエリファンアウトに備える
クエリファンアウトとは、AIが1つの質問を複数視点で分解(SubQuery化)する仕組みのことです。たとえばユーザーが「LLMOとは?」と尋ねた場合、AI内部では次のような分岐が生まれます。
| サブクエリ例 | AIが求める情報 | 対応コンテンツ |
|---|---|---|
| LLMOの定義は? | 概念・用語説明 | 定義文・グロッサリー |
| なぜ必要なのか? | 理由・背景 | 概要・導入章 |
| どんな施策がある? | 実務・手順 | FAQ/HowTo |
| 導入効果は? | 実績・成果 | 事例紹介 |
この構造に備えるには、FAQ構成+定義ページ+関連リンクを用いて情報を網羅的に整理することが重要です。特に「FAQスキーマ」をJSON-LDで実装しておくと、AIが質問と回答の対応を正確に読み取り、引用しやすくなります。
ナレッジグラフを意識した内部リンク設計
AIは、サイト全体を「知識のネットワーク」として理解します。GoogleやChatGPTなどのLLMが参照するナレッジグラフは、情報同士の関係(エンティティリンク)を基盤にして構築されています。
内部リンク設計は、この「AIが読む構造的文脈」を作る最も重要な要素の一つです。
内部リンク最適化ポイント
- 同一トピック群をクラスタ構造でまとめる
- 各ページに1つのピラーページ(中心記事)を設定
関連記事リンクは「関連概念」を優先(曖昧なタグではなく意味連携)- 構造化データで
mentions・sameAsを活用しする
| ページ役割 | 機能 | 例 |
|---|---|---|
| ピラーページ | トピック全体の概要 | 「LLMO対策とは?」 |
| サテライト記事 | 個別テーマの掘り下げ | 「構造化データ×LLMO」 |
| 定義ページ | 専門用語・概念解説 | 「クエリファンアウトとは?」 |
AIは内部リンクを通じて、文脈理解をすることができます。
単なるナビゲーションの意味で内部リンクを設置するのではなく、「AIに自社の強み(エンティティ)を学習させる」を意識することで、サイト全体がLLMにとって一貫した知識ベースとして評価されやすくなります。
チェックリスト②
構造化データを整備する
AI検索・生成AI時代のWeb最適化では、「構造化データ」は欠かせない要素です。AIは自然文だけではなく、ページ内に埋め込まれたSchema.orgのJSON-LDデータを読み取り、「このページが何を扱っているか」を理解・評価します。
適切なスキーマ実装は、SEOだけでなくAI引用・AI理解にも直接的な影響を与えます。
Article・FAQ・Organizationスキーマの設定
構造化データの中でも、AIが特に参照する頻度が高いのが次の3種です。これらは、検索エンジンとLLMの両方に理解される“基本構造”です。
| スキーマ名 | 役割 | 主な活用ページ | 効果 |
|---|---|---|---|
| Article | 記事の意味・内容を定義 | ブログ・コラム・ニュース | 検索結果にタイトル・著者表示/AI引用の根拠化 |
| FAQPage | 質問と回答のセット | よくある質問・解説記事 | SGEやChatGPT回答に転用されやすい |
| Organization | 発信元情報・企業信頼性 | コーポレートサイト | 信頼スコア・E-E-A-T強化 |
これらを1ページ内で組み合わせることで、AIは「誰が」「何を」「なぜ」発信しているかを完全に理解します。特に企業サイトでは、Article+Organizationのセットが基本構造です。
推奨構成例
"publisher": { "@type": "Organization", "name": "クーミル株式会社" },
"author": { "@type": "Person", "name": "馬鳥亮佑" }
これにより、AIが信頼性の高い一次情報としてページを扱うようになります。
著者・会社・記事の関係をスキーマで明示
AIは「どの企業(または専門家)が、どの情報を発信しているか」を識別します。
この信頼の三角関係を明示するのがスキーマ連携です。
正しいスキーマ構造(関係図)
Organization(会社)
 ├─ Article(記事)
 │   └─ Author(著者)
 └─ Publisher(同一組織)
実装例
{
 "@context": "https://schema.org",
 "@type": "Article",
 "headline": "LLMO対策チェックリストとは?",
 "author": { "@type": "Person", "name": "馬鳥 亮佑", "url": "https://coomil.co.jp/authors/batori" },
 "publisher": { "@type": "Organization", "name": "クーミル株式会社", "url": "https://coomil.co.jp/" }
}
このようにAuthor・Organizationを明示的にリンクさせることで、AIは「誰が専門的な立場から発信しているか」を理解します。
E-E-A-T(経験・専門性・権威性・信頼性)にも直結し、AI引用率の向上につながります。
AI検索に引用されやすいJSON-LD設計例
AIがWeb情報を引用する際、以下の3つの条件を満たした構造化データを優先的に評価します。
① 機械が意味を理解できる要素を含む
headline(タイトル)description(要約)mainEntityOfPage(ページID)dateModified(更新日)
② 出典を明確にする
"url"と"mainEntityOfPage"に実ページURLを明示"publisher"に会社情報を関連付け
③ AIに引用されやすい構造の例
{
 "@context": "https://schema.org",
 "@type": "FAQPage",
 "mainEntity": [{
   "@type": "Question",
   "name": "LLMO対策とは何ですか?",
   "acceptedAnswer": {
     "@type": "Answer",
     "text": "AI(大規模言語モデル)が情報を正確に理解・引用できるように最適化する施策のことです。"
   }
 }]
}FAQ構造を用いることで、ChatGPTやPerplexityが回答文を生成する際に部分引用(引用スニペット)しやすくなります。
つまり、「AIに理解される構造化」はAIに採用されるSEOでもあるのです。
これらの構造化マークアップを実装することで、検索エンジンやLLM(ChatGPTなど)からあなたのサイトを「信頼できる情報源」として認識しやすくなる構造が完成します。
チェックリスト③
E-E-A-T(専門性・信頼性)を強化
AIが参照・引用する情報を選定する際、最も重視するのが「誰が・どの立場から・どんな根拠で発信しているか」です。これはまさにE-E-A-T(経験・専門性・権威性・信頼性)の領域です。
LLMO対策においては、このE-E-A-Tを構造的に可視化することが不可欠です。
監修・実績・著者情報を明記する
AIは、記事本文だけでなく、ページ内の著者・監修情報を読み取り、「出典の信頼度」をスコア化します。特にauthorやpublisherスキーマを設定し、記事下部に監修者プロフィールを明記することが重要です。
- 氏名・肩書き(例:「SEOコンサルタント」「医療ライター」など)
- 所属組織や運営会社(
Organizationスキーマで連携) - 実績(登壇・受賞・メディア掲載など)
- SNS・LinkedIn・研究者IDなどの外部リンク
これらを明示することで、AIは「この情報は専門家が発信している」と判断します。特にChatGPTやPerplexityのような生成AIは、“発信者の信頼構造”を理解して回答精度を高める傾向にあります。
権威性のある外部参照リンクを活用
E-E-A-Tの「権威性(Authoritativeness)」は、他の信頼あるサイトとの関係性で評価されます。AIはリンク先の品質・関連性も解析し、「知識のネットワーク(ナレッジグラフ)」の一部として認識します。
- 官公庁・大学・学会など一次情報へのリンク
- 公的データ(総務省・経産省・Statista等)の活用
- 他社の引用・監修ページに自社リンクを掲載(双方向信頼)
| リンク先タイプ | AI評価 | コメント |
|---|---|---|
| 公的機関・学術情報 | 高 | 出典の根拠として引用されやすい |
| 業界メディア | 中 | 専門性補完に有効 |
| SNS・個人ブログ | 低 | 信頼度には直結しにくい |
AIは、被リンクだけでなくリンク構造の信頼性を解析しています。「誰を参照し、誰に参照されているか」がAI時代の新たな評価軸です。そのため、信頼性が高いメディアや関連性が高いメディアからの被リンクを増やすことも重要と言えるでしょう。
AIが信頼する「出典情報」の作り方
AIは出典・引用構造を通じて「知識の信頼性」を判断します。このため、明示的な出典情報と構造化データの整合性が欠かせません。
- 本文内に引用元を記載
→ 「出典:経済産業省2025年調査」などを明示。 - 構造化データに
citationまたはreferencesを追加
→ AIが自動で参照・照合できるようにする。 - 記事末尾に“情報提供・監修”の記載セクションを設置
→ 企業・監修者・編集者を明確化。
JSON-LD例
"citation": "https://www.meti.go.jp/report/2025/data.html",
"publisher": {
 "@type": "Organization",
 "name": "クーミル株式会社"
}このように、AIに「信頼の裏付け」を示すことで、SGEやPerplexityなどで信頼できる出典として引用される確率が高まります。このように、E-E-A-TはもはやSEO評価だけでなく、AI引用率の根幹要素になりつつあります。

チェックリスト④
トピッククラスタ構造を構築
AIがWeb上の情報を理解する際は、「どの情報が中心で、どの情報が補足か」という階層構造(トピッククラスタ)を分析しています。
これは、従来のSEOにおける内部リンク戦略を超え、AIが知識として整理・引用するための基礎構造です。正しくクラスタを設計することで、AIはあなたのサイトを専門領域の信頼ソースとして認識します。
ピラーページとサテライト記事の設計
トピッククラスタの中心となるのが「ピラーページ(基幹記事)」です。ピラーページがテーマ全体を包括し、そこから個別テーマ(サテライト記事)へと内部リンクで分岐します。
AIはこのリンク構造を通じて、ページ間の知識的関連性を理解します。
構成イメージ
ピラーページ:「LLMO対策とは?」
 ├─ サテライト①:「構造化データの最適化」
 ├─ サテライト②:「E-E-A-Tの可視化」
 └─ サテライト③:「AI引用率の測定方法」
設計ポイント
- ピラーページは包括的なテーマ(3000〜5000文字規模)
- サテライト記事は1テーマ1課題を深堀り
- 相互リンクは「関連記事」ではなく意味連携を意識
- JSON-LDの
@idで関連構造を明示する
この構造を整えることで、AIが「1つの知識体系」としてサイトを理解しやすくなります。
トピックごとの内部リンク戦略
内部リンクは単なる誘導ではなく、AIにとっても非常に重要な要素です。リンク構造を整理することで、AIが「どのトピックが主要で、どの情報が補足か」を判断できるようになります。
- トピック単位でのクラスタ管理
→ 例:「LLMO対策」クラスタ内でのみ双方向リンクを設定。 - リンクアンカーテキストを明確化
→ 「詳しくはこちら」ではなく、「構造化データの実装方法」など具体的に。 - 関連スキーマで補強
→ JSON-LDに"mentions"や"isPartOf"を設定。
| 要素 | 目的 | AI理解への影響 |
|---|---|---|
| アンカーテキスト | 意味付与 | クエリ関連性を明確化 |
| 双方向リンク | 構造明示 | クラスタ化の補強 |
| スキーマ連携 | 機械理解 | ナレッジグラフに組み込み |
内部リンクはAIにとって“知識グラフの接点”であり、構造化データと並ぶ重要要素です。
AIが理解する「知識のまとまり」を作る方法
AIは、単一ページよりも「関連情報のネットワーク」から知識を構築します。したがって、サイト全体で「トピックごとの知識のかたまり(クラスタ)」を意識した設計が有効です。
- テーマの階層化
例:
LLMO対策 > 構造化データ > JSON-LD実装 > Articleスキーマ - ページ群の関連付け
ピラーページからサテライト記事へ「親子リンク」構造を設定。 - 意味的ラベルを統一
タイトル・スキーマ・URL階層で一貫性を持たせる。
例:/llmo/structured-data//llmo/eeat/
- 構造化+内部リンクが一貫しているか
- 更新日・出典が整合しているか
- トピック単位で重複や欠損がないか
このように設計されたサイトは、AIのナレッジグラフに専門性が高いサイトとして登録されやすくなります。つまり、クラスタ構造はAIに“知識単位”で認識されるSEO基盤なのです。
このようなトピッククラスタ設計により、AIは個別ページを単体ではなく「知識体系の一部」として解析し、サイト全体を「特定分野に強いドメイン」として高く評価します。
チェックリスト⑤
定期的な情報更新
AIは一度Web上の情報を学習すると、その知識を「静的」に保持するわけではありません。ChatGPTやPerplexityなどのLLMは、定期的にWebデータを再学習・再構築しています。
つまり、「古い情報はAIから忘れられる」時代になっており、継続的な更新が検索・引用双方に影響します。ここでは、AIに“最新かつ信頼できるサイト”として認識され続けるための更新戦略を解説します。
dateModifiedタグで更新を明示
AIは、HTML上の更新日情報(dateModified)や構造化データの更新日を読み取り、「鮮度」の指標としています。Googleだけでなく、RAG(検索拡張生成)型AIでも「更新日」は優先的に扱われる要素です。
実装チェックポイント
- JSON-LD内に
"dateModified"を必ず設定 <meta property="article:modified_time">をHTML内に記述- 記事最下部に「最終更新日」を明示
例(構造化データ)
"dateModified": "2025-11-01"更新明示の効果
| 項目 | 効果 |
|---|---|
| SEO | 検索エンジンのクロール促進 |
| LLM | 最新情報ソースとして再学習対象に優先登録 |
| UX | 信頼性・透明性の向上 |
更新日を見えるようにすることで、ページのフレッシュネスを強調することができます。
LLM再学習の周期を意識した更新頻度
ChatGPT、Gemini、PerplexityなどのLLMは、数週間〜数ヶ月単位で再学習を行っています。したがって、「定期的な更新」を行うことも、AI認識の持続に効果的と言えます。
AIごとの学習サイクル(目安)
| AIモデル | 学習更新サイクル | 推奨更新頻度 |
|---|---|---|
| ChatGPT(GPT-5) | 約3〜4か月 | 数ヶ月に1回程度 |
| Gemini | 約2〜3か月 | 数ヶ月に1回程度 |
| Perplexity | 約2〜4週間 | 月1回程度 |
簡単にできる更新について
- 統計データや市場動向のアップデート
- 新サービス・製品の追加情報
- FAQ・料金・問い合わせ先の修正
小さな更新を継続的に行うことで、AIはサイトを「活動的な情報源」と判断します。逆に、1年以上更新がないページは“非アクティブページ”と見なされ、引用確率が低下する恐れがあります。
古い情報を削除・統合する運用ルール
AIはページ全体の「一貫性」を重視します。古い情報や矛盾した内容が残っていると、AIは混乱し、信頼スコアが下がるため、定期的に情報を整理し、冗長・重複ページを統合することが重要です。
整理・統合のステップ
- 重複ページの抽出
→ 旧記事・似たトピックを洗い出す。 - 最新情報に一本化
→ 古いURLから新URLへ301リダイレクト。 - 古いスキーマ削除/更新
→ 不要なdatePublishedやFAQを削除。 - アーカイブ方針を明確化
→ 公開終了ページには「過去情報」と注記。
ここでクーミルとしても提言したいのが、サイト更新とは「足すこと」ではなく、「整理し続けること」です。AIに一貫した知識として認識されるためには、情報の鮮度+整合性の両立が必要であることを今一度意識することが重要となります。
チェックリスト⑥
AIが読みやすい文章構造を採用する
AI時代の文章は「人に伝える」だけでは不十分です。
LLMが意味を正確に抽出し、要約・引用しやすい情報構造を持たせることが重要です。特にChatGPTやPerplexityなどは、見出し構造や文の論理的区切りを基準に内容を理解します。
ここでは、AIに誤読されない・引用されやすいテキスト構造の基本を解説します。
短文+箇条書きで論理を分割
AIは長文をそのまま理解するのではなく、「文単位で分割・再構成」して処理します。
そのため、1文を短く保ち、箇条書きを活用して論理のまとまりを明示すると、AIが正確に要約・引用できます。
改善前のイメージ:
LLMO対策はSEOとは異なり、AIに最適化するための戦略であり、構造化データやFAQ、E-E-A-Tの整備が重要です。
改善後:
LLMO対策はAI最適化の新しい概念です。
主な施策は次の3つです。
- 構造化データの設定
- FAQによる質問対応
- E-E-A-T(専門性・信頼性)の強化
AI理解を助ける文書ルール
- 1文は60〜80文字以内
- 箇条書きを1セクションに1回以上
- 接続詞(しかし・または・つまり)を明示して論理の流れを整理
こうした形式は、人間にも読みやすく、AIにも「文脈構造の明確な情報」として扱われます。
見出し下に要約文(150字前後)を配置
AIは見出し(H2/H3)直下の数文を「セクションの代表文」として抽出します。したがって、見出しの下に150字前後の“要約リード”を配置すると、AIがその章の内容を正確に要約・回答に活用できます。
具体例
H3:構造化データはAIの理解を助ける鍵
構造化データを正しく実装すると、AIがページ内容を正確に認識できます。
JSON-LDでスキーマを明示すれば、AIは「誰が」「何を」「どのように」発信しているかを文脈的に理解しやすくなります。
メリット
- ChatGPT・Perplexityの引用精度が向上
- 検索結果・要約カードでのCTR改善
- AI生成文での「誤引用・文脈切り取り」防止
| 要素 | 理想文字数 | 目的 |
|---|---|---|
| セクション要約文 | 約150字 | 意図の明示・AI要約補助 |
| 本文 | 300〜400字 | 情報補足・根拠提示 |
AIに伝える前提で構造化することで、文章が“理解される情報”へと変わります。
生成AIが部分引用しやすい書き方とは
生成AI(ChatGPT、Bing Copilotなど)は、文の中から「明確な主張・定義・数値」を抽出して引用します。そのため、AIが“引用しやすい文章”には、以下の特徴があります。
AI引用されやすい文構造のポイント
- 1文で1情報(複数主張を混在させない)
- 主語と述語を明確に(抽象語の多用を避ける)
- 固有名詞・数値・引用元を含む
- 「〜である」「〜といえる」など結論形で締める
引用されやすい例:
構造化データは、AIがWebページの内容を理解するための“翻訳装置”である。
引用されにくい例:
構造化データは、SEOやAI最適化の観点から重要だとされることが多い。
比較表:
| 要素 | 引用されやすい | 引用されにくい |
|---|---|---|
| 明確な主語 | あり(構造化データは…) | なし(重要とされる) |
| 定義文 | 明確 | 抽象的 |
| 文末 | 断定形 | 曖昧表現 |
AIは断定+具体的の文を好むため、意識的に「AIに引用される一文」を配置することで、ChatGPT・SGE・Perplexityなどの回答で部分引用率を高めることができます。
チェックリスト⑦
ページエクスペリエンス(UX)を最適化
AIは、ページの「内容」だけでなく「体験」も学習・評価の対象としています。
特にGoogleのCore Web Vitals(LCP・FID・CLS)は、AIが“信頼できる情報源”と判断する際の要素としても影響します。UX(ユーザー体験)の最適化は、人の滞在率を高めるだけでなく、AIが認識しやすい構造の維持にもつながります。
Core Web Vitalsの改善でAI評価を高める
Core Web Vitalsは、Googleが定義するユーザー体験の定量評価指標です。
AIも同様に、レスポンス速度や安定性を品質の一部として認識します。特にPerplexityやGeminiなどのAIブラウザ型検索では、ページが高速かつ安定して読み込まれるサイトを「引用候補」として優先します。
| 指標名 | 意味 | 目標値 | 改善施策 |
|---|---|---|---|
| LCP (Largest Contentful Paint) | メインコンテンツ表示速度 | 2.5秒以内 | 画像圧縮・CDN利用 |
| FID (First Input Delay) | 最初の操作反応速度 | 100ms以内 | JS遅延読み込み |
| CLS (Cumulative Layout Shift) | レイアウトの安定性 | 0.1以下 | CSS優先ロード |
モバイルにおける読み込み速度の最適化
現在のAIトラフィックの約70%はモバイル経由のアクセスです。
PerplexityやCopilotなどAIブラウザの多くは、モバイルUIを基準に解析を行います。そのため、モバイル対応=AI最適化対応と言っても過言ではありません。
- レスポンシブデザインで全要素が縮小・圧縮表示可能か
- スマホでのLCP(読み込み速度)を最優先に改善
- 画像形式をWebP/AVIFに統一
- Lazy Load(遅延読み込み)で初期表示を軽量化
測定ツール
AI検索でサムネイル・構造が崩れない設計
AIがページを引用・要約する際、OGPタグ・構造化データ・画像サイズの整合性が取れていないと、AI回答でレイアウトが崩れることがあります。特に、AIが自動生成するリッチカードやプレビュー内で崩れない設計が必要です。
崩れやすい要因と対策
| 問題 | 原因 | 対策 |
|---|---|---|
| サムネイルが欠落 | OGP未設定・サイズ不一致 | <meta property="og:image">を1200×630pxで統一 |
| 文章途中で切断 | HTML構造エラー・閉じタグ欠落 | ValidatorでHTML整合性をチェック |
| タイトル不整合 | title・og:title不一致 | 両者を統一し、AI引用時の精度を確保 |
構造保持のポイント
- JSON-LD・OGP・HTMLを一貫性のある設計にする
- メインビジュアル(サムネイル)を1枚固定に設定
<article>タグ内に主要コンテンツを集約(AI解析の対象範囲に含まれる)
こうした一貫した構造を維持することで、AIは「ページの意味構造」を正確に捉え、引用時に誤った文脈を生成しにくくなります。
チェックリスト⑧
外部評価・被リンクの質を見直す
AI時代の被リンクは、“順位を上げるための指標”ではなく、“信頼ネットワークの接続点”として扱われます。
ChatGPTやPerplexityなどのAIは、被リンクや参照リンクをもとに、どの情報が一次情報源であるかを判断しています。
そのため、単なる被リンク数ではなく、関連性・信頼性・引用可能性が重視される設計が必要です。
AIは「被リンク元の信頼性」を解析している
AIは被リンクの数よりも「誰からリンクされているか」を評価します。
ナレッジグラフ上で信頼性の高いサイト(政府機関・大学・業界メディアなど)からの参照は、AIがその情報を“権威的知識”として学習するきっかけになります。
被リンク評価のAI的観点
| 指標 | 内容 | AI評価への影響 |
|---|---|---|
| 出典の信頼度 | 公的機関・大学・専門団体 | 非常に高い(AI引用率上昇) |
| 関連性 | 同業種・同テーマ内のリンク | 高い(テーマ理解向上) |
| 更新頻度 | 被リンク元の活動性 | 中〜高(再学習で残りやすい) |
最適化のための実践
- 自社が専門とする分野の団体・協会に登録
- 業界メディア・ポータルへの寄稿
- 統計・資料ページを公開し「引用元」になれる情報を発信
AIは「誰に紹介されているか」であなたの専門性を評価しています。被リンクは“AIが信頼を学習する経路”であり、SEO以上に重要な意味を持ちます。
ナレッジネットワークに参加する発信戦略
AIのナレッジグラフは、情報の「つながり」を重視して知識を形成します。つまり、他の信頼サイト・データベース・SNSと関連づけられているほど“学習上の優先ノード”になります。
ナレッジネットワーク構築の具体策
- 業界レポート・ホワイトペーパーを外部に公開
- オウンドメディア同士での相互参照
- LinkedInやGoogleビジネスプロフィールで構造的な連携を設定
- 自社記事に
sameAs属性でSNS・メディアURLを関連付け
例(構造化データ内での連携)
"sameAs": [
 "https://x.com/coomil_jp",
 "https://www.linkedin.com/company/coomil/"
]
AI的な利点
- AIが「同一組織・同一人物」として情報を統合
- 外部サイトとの意味的ネットワークが強化
- “孤立したドメイン”と見なされるリスクを軽減
AIは単独で存在する情報よりも、ネットワーク内で相互に補完し合う知識を信頼します。
SNS・プレス・引用対策でAI理解を促進
AIはWeb記事だけでなく、SNS投稿やプレスリリースも学習対象としています。特にX(旧Twitter)やLinkedInなどの投稿は、最新性と一次性の高い情報源として扱われやすく、AI回答で引用されるケースも増えています。
AIが学習する外部シグナル
| メディア種別 | 学習頻度 | 特徴 |
|---|---|---|
| 公式プレスリリース | 高 | 出典として引用されやすい |
| SNS(X・LinkedIn) | 中 | トレンド性・速報性が評価される |
| 個人ブログ | 低 | 信頼スコアが不安定 |
| 動画・ポッドキャスト | 中 | 生成AIにおける補助情報として参照 |
効果的な実践方法
- プレスリリース配信サービス(PR TIMES等)を活用
- SNSで構造化リンク(OGP付き)投稿を定期実施
- 投稿内容をWeb記事へ内部リンクして「知識の往復」構造を形成
このように、外部評価の最適化は単なる被リンク施策ではなく、AIに「信頼のつながり」を可視化する戦略です。
関連性・信頼性・継続発信を意識した外部連携によって、サイトは“AIが参照する知識拠点”へと成長します。
チェックリスト⑨
AI引用率をモニタリングする
AI時代の分析指標は、「順位」ではなく「引用率」です。
これまでのSEOはクリックを測定するものでしたが、LLMO対策では“AIの回答内でどれだけ自社サイトが参照されているか”をトラッキングすることが成果指標となります。
ここでは、AI検索におけるパフォーマンスを可視化し、継続的に改善する方法を紹介します。
主要LLM(Perplexity・Bing Copilot・SGE)での引用傾向を分析
ChatGPT・Perplexity・Google SGE(Search Generative Experience)などのAIは、回答文中に引用元リンクを明示する傾向があります。
これを定期的にモニタリングすることで、自社ドメインがどの程度AI回答に採用されているかを確認できます。
チェック方法
- Perplexity:質問を入力 → “Sources”欄で参照元URLを確認
- Bing Copilot:回答右上の「引用番号」から出典を確認
- Google SGE:AI生成回答上部のリンク群をクリックで確認
記録すべき指標
| 指標 | 内容 | 評価目的 |
|---|---|---|
| 引用回数 | 期間内でのAI出典頻度 | AI露出度の測定 |
| 引用トピック | どのテーマで採用されているか | コンテンツ強化の方向性判断 |
| AI種別 | ChatGPT / Perplexity / SGE | モデルごとの傾向把握 |
AI経由トラフィックの測定方法
AI検索で引用された情報から実際にユーザーが流入しているかを把握することも重要です。
Googleアナリティクス(GA4)では現時点でAI流入を直接識別できませんが、参照元URLやUTMパラメータ分析で近似的に追跡可能です。
AIトラフィック測定の実践例
- Perplexity経由のアクセス:
referrer = perplexity.ai - Bing Copilot経由:
referrer = bing.com+ AIパラメータ付き - ChatGPTプラグイン経由:
utm_source=chatgptの導入
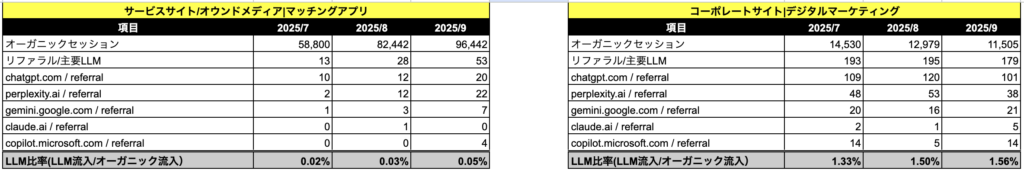
上記の画像はクーミルが管理するサイトへのLLM経由の流入数となります。このような形で月次でレポーティングすることでどのLLMから流入数が増えているか確認することができます。
KPI設計例
| 指標 | 定義 | 目標値 |
|---|---|---|
| AI引用率 | AI回答内の引用回数/総AI回答数 | 3〜5%(初期) |
| AI経由セッション率 | AI経由流入/全セッション | 1〜2%目標 |
| AIエンゲージメント率 | AI流入後の滞在時間・CV | SEO流入と同等以上 |
チェックリスト⑩
AI検索時代のブランド設計を行う
AI検索の時代では、「ブランド」は単なるロゴや社名ではなく、AIが知識の塊として認識する意味的アイデンティティになっています。
GoogleやChatGPTは、構造化データ・外部リンク・SNS・メンション情報を統合し、「どんな企業で、どの専門分野に強いか」を理解します。ここでは、AIに選ばれる“構造的ブランド”を作るための設計ポイントを解説します。
LLMに認識されるブランドストーリーの構築
AIは文章の表層だけでなく、「企業の一貫した語り」を学習します。
サイト全体・SNS・プレスなどで共通のブランドストーリー(Mission・Vision・Value)を発信することが、AIによる“意味的一貫性”として評価されます。
例えば、クーミルの場合は以下のような形となりあmす。
構築手順
- コアメッセージを統一する
→ 例:「Web制作 × Webマーケティング 」で一貫した表現を貫く。 - 複数チャネルで同一文脈を発信
→ コーポレート・LP・SNS・noteなどで同テーマを繰り返す。 - スキーマで文脈を明示
→ Mission・Service・PersonをOrganizationスキーマ内に記載。
企業情報・理念・ミッションを構造化データ化
ブランドをAIに正しく理解させるためには、感情的なコピーよりも構造的な定義が有効です。Organizationスキーマを用いて、企業理念や事業領域をAIに直接伝えることができます。
基本構造(例)
{
 "@context": "https://schema.org",
 "@type": "Organization",
 "name": "クーミル株式会社",
 "url": "https://coomil.co.jp/",
 "description": "Web制作とデータ分析で企業の成長を支援するデジタルパートナー。",
 "founder": "馬鳥 亮佑",
 "foundingDate": "2017-05-01",
 "missionStatement": "企業のWeb価値を最大化し、AI時代の成長基盤を創る。"
}
設定項目のポイント
descriptionは「理念+専門分野」を簡潔に表現missionStatementやknowsAboutで専門領域を定義sameAsでSNS・業界メディア・会社概要を接続
AIはこの構造をもとに「どの領域の企業か」「どんな強みを持つか」を明確に識別します。結果として、AI回答内に企業名が自然に引用される確率が高まります。
AI検索で「ブランドワード回答」を得る方法
AI検索(SGE・Perplexity・ChatGPTなど)は、特定企業やブランドを名指しで回答するケースが増えています。その状態を実現するには、ブランドワードの最適化(Brand Mention Optimization)が鍵です。
対策ステップ
- ブランド+専門領域の記事群を整備
→ 例:「クーミル株式会社 × 採用サイトSEO」「クーミル株式会社 × LLMO対策」 - 外部でのブランドメンションを増やす
→ 業界インタビュー・比較記事・プレス掲載 - 構造化データで“自社名”を関連語として登録
→sameAs・mentions属性でAIの関連性を強化。
AIがブランドを引用する仕組み
| 要素 | AIが参照するデータ | 出典例 |
|---|---|---|
| Web構造 | Organization / WebSiteスキーマ | コーポレートサイト |
| 記事文脈 | 固有名詞+専門領域の併記 | 「クーミル株式会社のSEO改善」 |
| 外部参照 | SNS・メディア・プレス | PR TIMES・LinkedIn等 |
AIにブランドを“回答内で言及”させるには、構造・文脈・外部評価の三位一体設計が必要です。
これにより、AIの回答で「おすすめのLLMO対策企業は?」と聞かれたとき、クーミル株式会社が引用候補として浮上する確率が高まります。
まとめ
本記事では、LLMO対策に取り組む企業に向けてAIに引用される企業になるためのチェックリストを紹介しました。LLMに引用されるためには、通常のSEO対策の領域のみならず、自社ブランドと強みをエンティティとして認識させる必要があります。
そのために、各種項目の運用や広報活動まで行う必要があるのです。このようにAIO対策について専門家に相談したい人はぜひクーミル株式会社までご相談ください。
クーミルでは、LLMOコンサルティングのみならず、実行支援まで一貫して対応可能です。Web制作会社だからこそAIフレンドリーなサイト構造へ改修することも可能です。